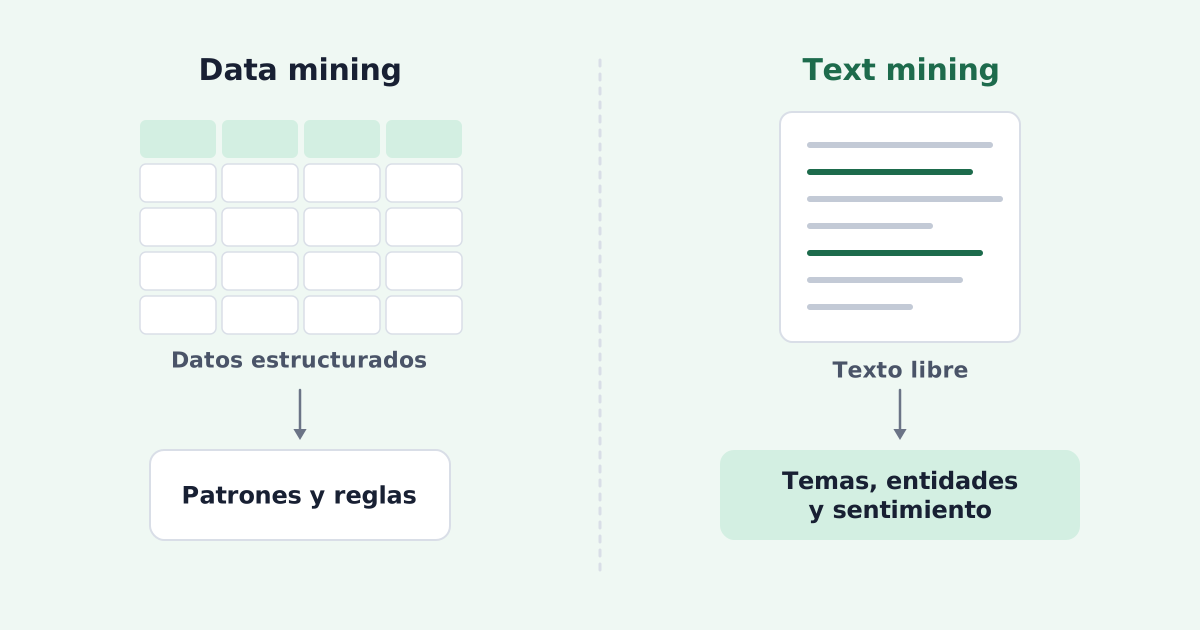
La minería de datos (data mining) y la minería de textos (text mining) buscan lo mismo: descubrir patrones útiles que no se ven a simple vista. La diferencia está en el material de partida. La minería de datos trabaja sobre datos estructurados, organizados en tablas. La minería de textos trabaja sobre texto libre: correos, opiniones, contratos, informes o publicaciones en redes.
Las diferencias de un vistazo
| Data mining | Text mining | |
|---|---|---|
| Datos | Estructurados: tablas, transacciones, registros | No estructurados: documentos, mensajes, opiniones |
| Primer paso | Limpiar e integrar tablas | Convertir el texto en una representación numérica |
| Técnicas típicas | Clasificación, regresión, clustering, reglas de asociación, detección de anomalías | Clasificación de textos, extracción de entidades, análisis de sentimiento, temas, búsqueda |
| Ejemplo | Qué productos se compran juntos | Qué opinan los clientes de un producto |
Qué es el data mining
La minería de datos es la fase de análisis dentro de un proceso más amplio que se conoce como KDD (Knowledge Discovery in Databases): seleccionar los datos, prepararlos, transformarlos, aplicar técnicas de minería e interpretar los resultados.
Sus técnicas principales son:
- Clasificación: asignar una categoría, por ejemplo si un cliente va a darse de baja o no.
- Regresión: predecir un valor numérico, como las ventas del mes que viene.
- Clustering: agrupar elementos parecidos sin etiquetas previas, como segmentos de clientes.
- Reglas de asociación: descubrir qué cosas aparecen juntas, como el clásico análisis de la cesta de la compra.
- Detección de anomalías: encontrar registros que no encajan, útil para fraude o averías.
Qué es el text mining
La minería de textos aplica ideas parecidas al lenguaje escrito, con un reto añadido: el texto no viene en columnas. El proceso típico es:
- Recopilar los documentos.
- Preprocesar: dividir en palabras o fragmentos, normalizar mayúsculas y acentos, eliminar ruido.
- Representar el texto con números: desde el recuento de palabras o TF-IDF hasta los embeddings, vectores que capturan el significado.
- Analizar con técnicas de clasificación, agrupamiento o extracción.
Sus aplicaciones más comunes:
- Búsqueda de información, como la de cualquier buscador.
- Reconocimiento de entidades: detectar nombres de personas, empresas, lugares o fechas.
- Clasificación: enviar cada incidencia al departamento correcto o detectar contenido ofensivo.
- Análisis de sentimiento: saber si una opinión es positiva, negativa o neutra.
- Detección de temas: descubrir de qué se habla en miles de documentos.
Un ejemplo sencillo en Python
Un clasificador de opiniones con TF-IDF y regresión logística, el enfoque clásico:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline

textos = [
    "El envío llegó tarde y la caja estaba rota",
    "Producto perfecto, repetiré seguro",
    "No funciona y nadie responde al teléfono",
    "Muy buena calidad y llegó en un día",
    "Una decepción, no lo recomiendo",
    "Encantado con la compra, todo correcto",
]
etiquetas = ["negativa", "positiva", "negativa", "positiva", "negativa", "positiva"]

clasificador = make_pipeline(TfidfVectorizer(), LogisticRegression())
clasificador.fit(textos, etiquetas)
print(clasificador.predict(["Llegó rota y tarde"]))
Con seis ejemplos solo sirve para ilustrar la idea. En un caso real se entrena con miles de textos etiquetados.
Cómo han cambiado los modelos de lenguaje el text mining
Los grandes modelos de lenguaje han transformado la minería de textos:
- Clasificar sin entrenar: basta con describir las categorías en las instrucciones.
- Extraer datos estructurados: pedir al modelo que devuelva, por ejemplo, el importe, la fecha y el proveedor de una factura en formato JSON.
- Resumir colecciones de documentos.
- Buscar por significado con embeddings, la base de los sistemas RAG que responden preguntas sobre documentos propios. Lo explicamos en RAG, fine-tuning o prompting.
Eso no hace obsoletas las técnicas clásicas. Con millones de documentos, un clasificador como el del ejemplo es mucho más barato y rápido, y más fácil de auditar. En la práctica se combinan: el modelo de lenguaje ayuda a etiquetar los datos y un modelo pequeño los clasifica a escala. En los dos casos, hay que medir la calidad con un conjunto de evaluación antes de confiar en el resultado.