Pandas es la librería de Python más usada para trabajar con datos en forma de tabla. Sirve para leer ficheros y bases de datos, limpiar y transformar datos, calcular estadísticas y preparar la información para un modelo de aprendizaje automático. Si vas a dedicarte a la ciencia de datos, es probablemente la primera librería que vas a aprender después del propio Python.
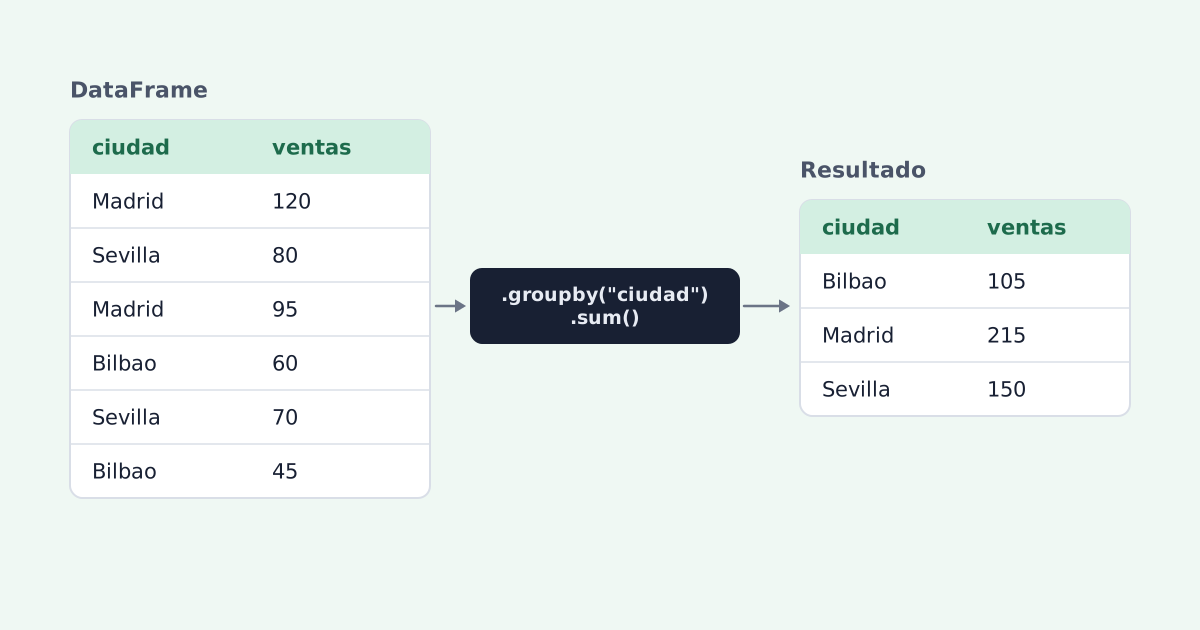
En esta guía explicamos qué es, para qué sirve y cómo dar los primeros pasos con ejemplos de código, incluidas las novedades de pandas 3.0.
Qué es pandas
Pandas es una librería de código abierto construida sobre NumPy. Aporta dos estructuras de datos:
- Series: una columna de datos con un índice.
- DataFrame: una tabla con filas y columnas, cada una con su tipo de dato.
Sobre ellas ofrece cientos de operaciones: leer y escribir CSV, Excel, JSON, Parquet o bases de datos SQL; filtrar y seleccionar; tratar valores que faltan; agrupar y agregar; unir tablas; y manejar fechas y series temporales.
Para qué sirve
- Limpiar y preparar datos: corregir tipos, eliminar duplicados, rellenar huecos.
- Explorar: ver distribuciones, detectar valores raros, calcular resúmenes.
- Agregar: totales y medias por cliente, por mes o por región.
- Combinar fuentes: cruzar ventas con clientes o con un catálogo de productos.
- Trabajar con series temporales: remuestrear por semanas, calcular medias móviles.
- Preparar datos para modelos: pandas es la entrada habitual de scikit-learn y de muchas otras librerías.
Instalación
pip install pandas pyarrow
pyarrow no es obligatorio, pero se recomienda: pandas 3.0 lo usa por debajo para trabajar con texto de forma más rápida y para leer y escribir ficheros Parquet.
Primeros pasos con un ejemplo
Supongamos un fichero ventas.csv con las columnas fecha, cliente_id, ciudad, producto, importe y descuento.
import pandas as pd

ventas = pd.read_csv("ventas.csv", parse_dates=["fecha"])

ventas.head()      # primeras filas
ventas.info()      # columnas, tipos y valores no nulos
ventas.describe()  # estadísticas de las columnas numéricas
Seleccionar y filtrar
madrid = ventas.loc[ventas["ciudad"] == "Madrid", ["fecha", "producto", "importe"]]
grandes = ventas.query("importe > 1000")
Crear columnas
ventas["importe_con_iva"] = ventas["importe"] * 1.21
ventas["mes"] = ventas["fecha"].dt.to_period("M")
Agrupar y resumir
por_ciudad = (
    ventas.groupby("ciudad")["importe"]
    .agg(total="sum", media="mean", pedidos="count")
    .sort_values("total", ascending=False)
)
Unir tablas
clientes = pd.read_csv("clientes.csv")
completo = ventas.merge(clientes, on="cliente_id", how="left")
Tratar los valores que faltan
ventas.isna().sum()  # cuántos faltan por columna
ventas["descuento"] = ventas["descuento"].fillna(0)
ventas = ventas.dropna(subset=["cliente_id"])
Guardar el resultado
por_ciudad.to_csv("resumen_por_ciudad.csv")
completo.to_parquet("ventas_completas.parquet")
Novedades de pandas 3.0
Pandas 3.0 se publicó en enero de 2026 y trae cambios que conviene conocer si vienes de versiones anteriores:
- Nuevo tipo para texto: las columnas de texto se crean con el tipo
stren lugar deobject, más rápido y con menos memoria, sobre todo si tienespyarrowinstalado. - Copy-on-Write por defecto: el resultado de seleccionar una parte de un DataFrame se comporta siempre como una copia. Desaparece el famoso aviso
SettingWithCopyWarningy la asignación encadenada deja de funcionar. - Expresiones con
pd.col: una primera versión de una sintaxis más sencilla para crear columnas conassign. - Fechas con resolución en microsegundos por defecto, lo que evita errores con fechas anteriores a 1678 o posteriores a 2262.
El cambio que más código rompe es el de la asignación encadenada:
# Ya no funciona en pandas 3.0
ventas["descuento"][ventas["importe"] > 1000] = 0.1

# Forma correcta
ventas.loc[ventas["importe"] > 1000, "descuento"] = 0.1
Para actualizar un proyecto, el equipo de pandas recomienda pasar primero a la versión 2.3, corregir todos los avisos y después subir a la 3.0.
Pandas y el resto del ecosistema
Pandas no está solo. Con volúmenes que no caben cómodamente en memoria, Polars o DuckDB suelen ser más rápidos; para cálculo numérico se baja a NumPy; y para modelos se pasa a scikit-learn o PyTorch. Aun así, pandas sigue siendo el idioma común para explorar datos y el formato que entienden casi todas las librerías.
Pandas en la era de la IA generativa
Los asistentes y los agentes de código escriben código de pandas con mucha soltura: basta con describir la transformación que quieres. Pero cometen errores sutiles, como uniones que duplican filas, agrupaciones por la columna equivocada o fechas mal interpretadas. Entender pandas es lo que te permite revisar ese código y fiarte del resultado.